Skip to content

Blog

Portable LaTex

Dato che ho l'esigenza di creare dei documenti LaTex sulla mia macchina Windows 11, ho verificato quali soluzioni siano possibili.

Esiste un'ampia scelta di possibilità ma dato che il mio utilizzo sarà saltuario, ho ritenuto che la versione MikTex fosse la più vicina alle mie esigenze, soprattutto per il fatto che si trova disponibile anche in versione Portable.

Ho quindi deciso di installarla sotto la mia cartella usuale per i software portable:

 c:\Users\[username]\Documents\sw\

Nella sezione MikTex Downloads si trova la versione Windows, ed è possibile scegliere l'installer standard, la versione "portable" oppure la versione installabile a riga di comando, utile per distribuire il software in automatico su numerosi computer aziendali.

La versione "portable" in realtà non richiede un installer separato: va semplicemente scaricato l'installer per windows e rinominato in miktex-portable.exe. Una volta eseguito è necessario assicurarsi di scegliere la seguente cartella di destinazione:

c:\Users\[username]\Documents\sw\miktex\

al cui interno si troverà lo script miktex-portable.cmd pronto per essere lanciato.

Tale script una volta lanciato apre una piccola icona nella barra di windows, dalla quale è possibile lanciare il terminale TeXworks. Oppure, in alternativa, è possibile eseguire ogni programma che si troverà nel seguente percorso:

c:\Users\[username]\Documents\sw\miktex\texmfs\install\miktex\bin\x64\

Un file di partenza che ho incominciato ad utilizzare è il seguente:

\documentclass{article}

\usepackage{graphicx}
\usepackage{amsmath}

\input{./pandoc_syntax.tex}

\begin{document}
    \input{./title.tex}
    \tableofcontents
    \newpage

    \section{Hello World!} % creates a section

    \textbf{Hello World!} Today I am learning \LaTeX. %notice how the command will end at the first non-alphabet charecter such as the . after \LaTeX
     \LaTeX{} is a great program for writing math. I can write in line math such as $a^2+b^2=c^2$ %$ tells LaTexX to compile as math
     . I can also give equations their own space: 
    \begin{equation} % Creates an equation environment and is compiled as math
    \gamma^2+\theta^2=\omega^2
    \end{equation}
    If I do not leave any blank lines \LaTeX{} will continue  this text without making it into a new paragraph.  Notice how there was no indentation in the text after equation (1).  
    Also notice how even though I hit enter after that sentence and here $\downarrow$
     \LaTeX{} formats the sentence without any break.  Also   look  how      it   doesn't     matter          how    many  spaces     I put     between       my    words.

    For a new paragraph I can leave a blank space in my code.
\end{document}

dove ho importato la seguente definizione dei colori:

% color syntax from pandoc
\usepackage{color}
\usepackage{fancyvrb}
\newcommand{\VerbBar}{|}
\newcommand{\VERB}{\Verb[commandchars=\\\{\}]}
\DefineVerbatimEnvironment{Highlighting}{Verbatim}{commandchars=\\\{\}}
\newenvironment{Shaded}{}{}
\newcommand{\AlertTok}[1]{\textcolor[rgb]{1.00,0.00,0.00}{\textbf{#1}}}
\newcommand{\AnnotationTok}[1]{\textcolor[rgb]{0.38,0.63,0.69}{\textbf{\textit{#1}}}}
\newcommand{\AttributeTok}[1]{\textcolor[rgb]{0.49,0.56,0.16}{#1}}
\newcommand{\BaseNTok}[1]{\textcolor[rgb]{0.25,0.63,0.44}{#1}}
\newcommand{\BuiltInTok}[1]{#1}
\newcommand{\CharTok}[1]{\textcolor[rgb]{0.25,0.44,0.63}{#1}}
\newcommand{\CommentTok}[1]{\textcolor[rgb]{0.38,0.63,0.69}{\textit{#1}}}
\newcommand{\CommentVarTok}[1]{\textcolor[rgb]{0.38,0.63,0.69}{\textbf{\textit{#1}}}}
\newcommand{\ConstantTok}[1]{\textcolor[rgb]{0.53,0.00,0.00}{#1}}
\newcommand{\ControlFlowTok}[1]{\textcolor[rgb]{0.00,0.44,0.13}{\textbf{#1}}}
\newcommand{\DataTypeTok}[1]{\textcolor[rgb]{0.56,0.13,0.00}{#1}}
\newcommand{\DecValTok}[1]{\textcolor[rgb]{0.25,0.63,0.44}{#1}}
\newcommand{\DocumentationTok}[1]{\textcolor[rgb]{0.73,0.13,0.13}{\textit{#1}}}
\newcommand{\ErrorTok}[1]{\textcolor[rgb]{1.00,0.00,0.00}{\textbf{#1}}}
\newcommand{\ExtensionTok}[1]{#1}
\newcommand{\FloatTok}[1]{\textcolor[rgb]{0.25,0.63,0.44}{#1}}
\newcommand{\FunctionTok}[1]{\textcolor[rgb]{0.02,0.16,0.49}{#1}}
\newcommand{\ImportTok}[1]{#1}
\newcommand{\InformationTok}[1]{\textcolor[rgb]{0.38,0.63,0.69}{\textbf{\textit{#1}}}}
\newcommand{\KeywordTok}[1]{\textcolor[rgb]{0.00,0.44,0.13}{\textbf{#1}}}
\newcommand{\NormalTok}[1]{#1}
\newcommand{\OperatorTok}[1]{\textcolor[rgb]{0.40,0.40,0.40}{#1}}
\newcommand{\OtherTok}[1]{\textcolor[rgb]{0.00,0.44,0.13}{#1}}
\newcommand{\PreprocessorTok}[1]{\textcolor[rgb]{0.74,0.48,0.00}{#1}}
\newcommand{\RegionMarkerTok}[1]{#1}
\newcommand{\SpecialCharTok}[1]{\textcolor[rgb]{0.25,0.44,0.63}{#1}}
\newcommand{\SpecialStringTok}[1]{\textcolor[rgb]{0.73,0.40,0.53}{#1}}
\newcommand{\StringTok}[1]{\textcolor[rgb]{0.25,0.44,0.63}{#1}}
\newcommand{\VariableTok}[1]{\textcolor[rgb]{0.10,0.09,0.49}{#1}}
\newcommand{\VerbatimStringTok}[1]{\textcolor[rgb]{0.25,0.44,0.63}{#1}}
\newcommand{\WarningTok}[1]{\textcolor[rgb]{0.38,0.63,0.69}{\textbf{\textit{#1}}}}
% end of color syntax

e la seguente prima pagina:

\begin{titlepage}
    \newcommand{\HRule}{\rule{\linewidth}{0.4mm}}

    \center
    \textsc{\LARGE Marjor heading}\\[0.5cm] % Major heading such as course name
    \textsc{\large Main heading}\\[0.5cm] % Main heading such as the name of your university/college
    \textsc{\large Course title}\\[1.5cm] % Minor heading such as course title
    \includegraphics[width=4cm]{logo.jpg}\\[1.5cm]


    \HRule\\[0.4cm]
    {\huge\bfseries Project}\\[0.4cm]   
    \HRule\\[2.5cm]

    {\large\textit{Author}}\\
    Federico \textsc{Thiella}

    \vfill\vfill\vfill

    {\large\today}
    \vfill
\end{titlepage}

Per inserire del codice sorgente correttamente colorato e formattato, ho pensato di scrivere il codice in formato Markdown e di tradurlo in LaTex con Pandoc

pandoc codice.md -t latex

anche Pandoc sarà oggetto di un prossimo articolo!
Portable Tomcat

In questi giorni avevo necessità di testare nella mia macchina di sviluppo delle servlet utilizzando la versione portable di Apache Tomcat.

Di seguito la procedura che ho utilizzato.

Predisposizione Ambiente

Ho scelto di installare tutti i software portable sotto la directory sw della cartella dei documenti:

c:\Users\[username]\Documents\sw\

Ho quindi scaricato la versione 64-bit per Windows in formato zippato dalla sezione Download di Tomcat 10 ed ho estratto il contenuto in:

c:\Users\[username]\Documents\sw\apache-tomcat-10\

Il sistema richiede che sia definita la variabile di ambiente JRE_HOME, nel caso in cui non sia già configurata nel sistema è consigliabile predisporre il file setenv.bat all'interno della cartella bin come segue:

@echo off
set "JRE_HOME=c:\Program Files\Java\jdk-17.0.2\"
exit /b 0

Attivazione del server

Dato che si tratta di un ambiente di test, non ho necessità che il sistema sia sempre in esecuzione ma lo voglio lanciare quando necessario.

I comandi da lanciare sono pertanto, in sequenza, i seguenti:

setenv.bat
catalina.bat run

Mentre per terminare è sufficiente un normale CTRL+C.

Configurazione CmdEr

Dato che utilizzo il sistema CmdEr ho pensato di predisporre il seguente script che configura l'ambiente e lancia il server. L'ho chiamato catalina.cmd all'interno del seguente percorso C:\Users\[username]\Documents\sw\cmder\bin in modo che sia disponibile direttamente dalla console:

@echo on
pushd "c:\Users\[username]\Documents\sw\apache-tomcat-10.0.27\bin\"
call setenv.bat
call catalina.bat %*
popd

Configurazione utente Tomcat

Sotto la directory conf di Tomcat si trova il file di configurazione tomcat-users.xml al quale ho aggiunto, nella sezione users, la seguente definizione:

Accesso al sistema

Il sistema è accessibile quindi via browser al seguente indirizzo http://localhost:8080/.

L'installazione in ambiente di produzione richiede naturalmente una configurazione più attenta e curata (gestione privilegi utente, permessi file e directory, gestione servizi, gestione e rotazione log, ...) ma non è oggetto di questo articolo.

Recuperare una Password cifrata da Pentaho

Connessioni Database

Se si utilizza un repository centralizzato su database, Pentaho registra le informazioni legate alle connessioni (host_name, database_name, ..) nella tabella r_database, assieme alle credenziali in formato "offuscato". Non si tratta di un hash monodirezionale ma di un formato che, pur non direttamente leggibile, può essere facilmente decifrato.

select
  id_database,
  name,
  username,
  password
from
  r_database

Recupero password Offuscate

Le password offuscate sono precedute dalla stringa Encrypted. Se prendiamo come esempio la password prova, questa verrà salvata in tabella con la stringa Encrypted 2be98afc86aa7f2e4cb79ce60cc9db9db.

Quale metodo viene utilizzato per codificare e decodificare le password? Pentaho utilizza la libreria Encr.java che richiama diverse funzioni presenti in KettleTwoWayPasswordEncoder.java.

Un sistema per decifrare la password è dimostrato nella trasformazione Pentaho-Kettle-Password-Decrypt che lo trovo interessante perché permette di integrare la libreria Java che gestisce l'offuscamento delle password all'interno di una trasformazione, importanto la libreria e definendo la funzione da richiamare:

import org.pentaho.di.core.encryption.Encr;
Encr.decryptPassword(encrypted_password)

Tuttavia non è strettamente necessario utilizzare questo sistema.

Facendo una breve analisi del codice sorgente, si riesce facilmente ad individuare la logica del funzionamento, ovvero la definizione di una chiave "segreta":

public KettleTwoWayPasswordEncoder() {
    String envSeed = Const.NVL( EnvUtil.getSystemProperty( Const.KETTLE_TWO_WAY_PASSWORD_ENCODER_SEED ), "0933910847463829827159347601486730416058" ); // Solve for PDI-16512
    Seed = envSeed;
}

(che corrisponde alla costante KETTLE_TWO_WAY_PASSWORD_ENCODER_SEED nel caso essa sia configurata, oppure al valore fisso 0933910847463829827159347601486730416058)

e l'algoritmo di codifica/decodifica che, senza sorpresa, avviene semplicemente tramite OR esclusivo. Il codice che decifra la password, semplificando al massimo e togliendo diversi controlli, è sostanzialmente questo:

import java.math.BigInteger;

public class Main
{
        public static void main(String[] args) {
                String envSeed = "0933910847463829827159347601486730416058";
                String encrypted = "2be98afc807ce808daa1dab65d281bc8e";
                int RADIX = 16;

                BigInteger bi_confuse = new BigInteger( envSeed );
                BigInteger bi_r1 = new BigInteger( encrypted, RADIX );
                BigInteger bi_r0 = bi_r1.xor( bi_confuse );

                System.out.println(new String( bi_r0.toByteArray() ));
        }
}

"Dato un sufficiente numero di occhi, i bug tendono a zero" non funziona

Commento su un blog del 2022, in risposta a una discussione sulla Legge di Linus e sul ruolo del code review nell'open source.

L'idea che "dato un sufficiente numero di occhi, i bug tendono a zero" non funziona.

Trovare bug è un lavoro a tempo pieno, e spesso complesso. Non è che ti metti a leggere il codice sorgente sotto l'ombrellone e sei in grado di scoprire e risolvere i bug. Qualcuno forse, ma solo se il bug è banale o il codice è stato scritto da un principiante.

Il problema della Legge di Linus

La frase di Eric Raymond — "given enough eyeballs, all bugs are shallow" — è una semplificazione affascinante ma fuorviante. Funziona per i bug evidenti, quelli che si vedono leggendo il codice con attenzione. Non funziona per i bug che contano davvero.

I bug seri sono spesso:

  • di concorrenza, si manifestano solo in determinate condizioni di timing, e non si vedono leggendo il codice;
  • di stato, dipendono da una sequenza specifica di operazioni, che il lettore non può ricostruire senza eseguire il programma;
  • di casi limite, coinvolgono input che il lettore non ha motivo di considerare, perché non sono nel percorso principale;
  • di integrazione, emergono solo quando il codice interagisce con altri componenti, versioni diverse, ambienti diversi.

Questi bug non si trovano "guardando". Si trovano testando, strumentando, eseguendo. E il code review, da solo, non basta.

Il caso del codice offuscato

Se poi qualcuno vuole intenzionalmente offuscare del codice e nascondere delle funzionalità, il discorso cambia completamente.

Il code review diventa inefficace: il codice è scritto apposta per sembrare innocuo. Servono analisi dinamiche, reverse engineering, strumenti di tracing. E anche con tutto questo, dipende caso per caso: potrebbe essere molto difficile da scoprire.

Questo vale sia per il codice open source che per quello proprietario. Anzi, nel caso del codice proprietario la situazione è peggiore, perché non hai nemmeno la possibilità di leggere il sorgente.

Conclusione

La Legge di Linus ha un fondo di verità — più occhi possono trovare più bug — ma è una verità statistica, non una garanzia. E vale solo per i bug che si possono trovare leggendo. Gli altri richiedono lavoro, strumenti, e tempo.

Trovare bug è un mestiere. Non è una passeggiata sotto l'ombrellone.

Nomi di colonna con spazi: fastidio estetico o problema di sicurezza?

Commento su un blog, in risposta a una discussione sui nomi di colonna non convenzionali nei database.

La maggior parte dei sistemi di database lo permette, qualsiasi carattere può essere utilizzato per il nome della colonna, ma non è necessariamente una buona idea.

Generalmente mi danno un senso di poca professionalità, e se utilizzate con sistemi o framework poco professionali il disastro è servito (es. export su CSV senza utilizzare librerie adeguate per il CSV).

Se il sistema è solido però nessun problema, solo il fastidio estetico per delle query "brutte" e poco eleganti che necessitano di caratteri di quoting non standard tra i diversi db.

Anche se devo ammettere che di query brutte ce ne sono tante, e non è sempre il problema degli spazi...


Anni dopo, lavorando a filtersql, mi sono trovato ad affrontare lo stesso problema da un'altra angolazione: non più come "fastidio estetico", ma come vero e proprio problema di sicurezza.

La maledizione dei telefoni rotti

Commento del settembre 2021 su un blog, in risposta a un post sui telefoni e sulla loro fragilità.

In effetti stavo ricostruendo gli ultimi anni della mia vita:

  • ho chiuso il vecchio telefono nella portiera della macchina e si è crepato, pazienza era vecchio;
  • così ho comprato un nuovo telefono per mia moglie ed ho utilizzato il suo vecchio, dopo 4 mesi mi è caduto e si è rotto il vetro, pazienza era vecchio anche questo;
  • ne ho comprato uno di fascia bassa, mi è durato 8 mesi poi ho rotto il vetro, non valeva la pena cambiarlo;
  • anche mia moglie ha rotto il vetro, ma lo abbiamo fatto cambiare;
  • nel frattempo mi sono procurato un dual sim da utilizzare sia per casa che per lavoro;
  • dopo 6 mesi si è bruciato (era coperto da garanzia kasko);
  • me l'hanno cambiato con uno identico, dopo 4 mesi l'ho perso in giardino sotto una copiosa nevicata (era assicurato per danni ma non per smarrimento...), poi però dato che il giardino non era poi così grande, scavando bene l'ho ritrovato dopo 4 giorni perfettamente funzionante;
  • sembrava troppo bello per essere vero, infatti il mese dopo mi è caduto di nuovo, ma era assicurato;
  • il vetro cambiato del telefono di mia moglie sfarfallava... così ha comprato un telefono nuovo;
  • l'ultimo mio telefono dual sim per ora è in perfette condizioni, sono già passati 7 mesi, ma ho dovuto comprare una bruttissima e grossa custodia stile nokia anni '90, anche perché penso che l'assicurazione mi stia tenendo sotto controllo.

Ecco perché non ho alcuna intenzione di tenere in tasca un telefono da più di 1000 euro... ma anche 300 sono tanti, mi sento come se fossi in una stazione dei treni in mezzo a tanta gente con delle banconote che mi spuntano dalle tasche pronte a prendere il volo...

Lo stesso problema ce l'ho con occhiali, orologi, penne, biciclette ed ombrelli ovviamente.

Quando cd fallisce, rm non perdona

Commento su un blog, in risposta a una discussione su script schedulati e cattive pratiche in shell scripting.

Ho visto di peggio (ma non sono stato io!), ad esempio il seguente task schedulato - semplifico un po':

cd /var/programma/temp
rm -rf *

Nessun errore, tutto corretto no? Tutto funziona alla perfezione per diverso tempo.

Sennonché un giorno il disco dove si trova la cartella temp va in fault, ma niente di grave: alla fine è solo una cartella temp...

...poi però parte il task schedulato, il comando cd va in errore ma lo script non intercetta l'errore e continua...


Nota tecnica: il rm -rf * viene eseguito nella directory corrente. In cron, la directory corrente è la home dell'utente (o / se lo script gira come root). Il risultato è che lo script cancella tutto quello che trova lì, non quello che credeva di cancellare.

Due caratteri fanno la differenza:

cd /var/programma/temp && rm -rf *

L'operatore && esegue il secondo comando solo se il primo è andato a buon fine. Se cd fallisce, rm non viene eseguito.

L'AI vista da chi l'ha studiata vent'anni fa

Commento del 2021, prima dell'esplosione degli LLM. Molte delle cose che scrivevo allora le penso ancora, ma il contesto è cambiato: oggi l'AI non è più solo una questione scientifica, è una questione politica, economica e sociale. Il commento va letto con quella consapevolezza.

Ho studiato AI circa 20 anni fa e vedo che le critiche che si fanno oggi sono le stesse di una volta, nonostante gli enormi ed evidenti progressi in merito.

Certamente il termine "intelligenza" è stato scelto dal marketing e non dagli scienziati, mentre per definizione una macchina è considerata "pensante" se è in grado di fare la scelta "migliore" con i dati che ha a disposizione. In questo senso una macchina può davvero essere intelligente, tanto quanto un aereo è senz'altro in grado di volare pur non cercando minimamente di imitare il volo degli uccelli.

Dire che tutta la AI si basi sul "pattern recognition" o meglio ancora sulla classificazione è estremamente riduttivo. La classificazione è un sottoinsieme dell'apprendimento automatico che a sua volta è un sottoinsieme dell'intelligenza artificiale.

Un non informatico che vede dei semafori che viaggiano in autostrada vede il fallimento, a me invece sembra un risultato fantastico, il risultato in termini scientifici è notevole.

[Qui mi riferivo a quei video di demo di computer vision in cui il sistema di riconoscimento "vede" un semaforo dove non c'è, magari su un'immagine di un'autostrada. Un non informatico guarda la scena e pensa "ma che scarso, non riconosce nemmeno un semaforo!". Ma il punto non è l'errore: è che il sistema ha imparato qualcosa sulla forma dei semafori. Un essere umano non ci fa caso perché riconosce il contesto; la macchina non ha ancora quel livello di comprensione. Ma il salto tecnico rispetto a dieci anni prima è enorme.]

Già da oggi ci sono determinati ambiti in cui le macchine battono notevolmente gli umani, ho visto di recente un sistema che analizza le tac per la diagnosi di ictus, e che produce un risultato in un paio di minuti contro i 20-30 di una diagnosi manuale. Si tenga conto che ogni minuto di ritardo è un'enormità dal punto di vista clinico.

E tutta l'analisi dei big data? Senza le macchine non sarebbe possibile.

Significa che il computer è più intelligente di un umano? Certamente no, ma il suo aiuto è insostituibile. Va però scelto quando affidarsi ad esso: chi lascia il controllo del volante ad un sistema automatico non dimostra certamente più intelligenza della macchina cui si affida.

Simple Ajax Form

Vaccinazioni senza prenotazione

La campagna vaccinazioni in Italia è partita in ritardo ed in modo disorganizzato. Nei mesi di Marzo ed Aprile 2021 diverse sedute sono state aperte al pubblico senza appuntamento, e centinaia di anziani si sono trovati in fila fuori dai centri vaccinali, tutti nello stesso momento, e sono stati costretti ad attendere diverso tempo prima di poter fare l'accettazione ed ottenere il loro turno.

Per poter accedere alla vaccinazione è necessario compilare il "Modulo di Consenso Informato" ed una scheda con l'anamnesi. Dato che le sedute erano senza appuntamento, la maggior parte delle persone in fila non disponevano dei moduli che dovevano quindi essere distribuiti e compilati a mano.

Abbiamo pensato che la predisposizione automatica di un modulo stampato con i dati del paziente avrebbe potuto mettere un po' di ordine ed aiutato a velocizzare la fase di accettazione.

Modulo automatico

L'anagrafe dei Pazienti è a disposizione in diversi formati, anche su Postgresql e le postazioni di accettazione dispongono tutte di collegamento VPN verso la rete aziendale.

L'idea iniziale era quindi di leggere tramite penna ottica il codice a barre della tessera sanitaria, e tramite la predisposizione di una stampa-unione Word si sarebbe potuto predisporre e stampare il documento corretto.

Modulo Consenso

Tuttavia questa soluzione richiede l'installazione del pacchetto Microsoft Word oppure Microsoft Office, e l'installazione e configurazione dei driver ODBC per Postgresql.

Ho pensato invece di utilizzare una macro Word e di esporre il codice tramite Web API

Codice Word

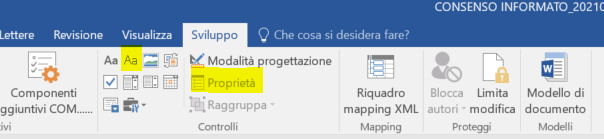
Per visualizzare gli strumenti per sviluppatori è necessario abilitare il relativo menù:

  • Nella scheda File passare a Opzioni> Personalizzazione barra multifunzione.
  • In Personalizzazione della barra multifunzione e Schede principali selezionare la casella di controllo Sviluppo.

A questo punto è disponibile il menù attraverso il quale sarà possono aggiungere dei controlli direttamente nel testo del documento:

Menù sviluppatore

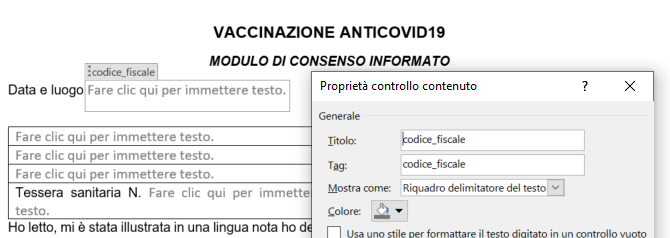
e tramite il pulsante proprietà andiamo ad assegnare un nome ad ogni controllo:

Proprietà controllo

tramite codice VBA andremo a leggere i dati dalla WEB API ed a caricare il risultato in ogni singolo controllo.

Sub GetPatientData(cf As String)
    Dim hReq As Object
    Dim response As String
    Dim Result

    On Error Resume Next

    Dim strUrl As String
    strUrl = "http://webserver/anagrafe/api?cf=" & cf

    Set hReq = CreateObject("MSXML2.XMLHTTP")
    With hReq
        .Open "GET", strUrl, False
        .Send
    End With

    response = hReq.ResponseText
    Result = Split(response, "::")

    Dim cc As ContentControl
    For Each cc In ActiveDocument.ContentControls
        If cc.Title = "codice_fiscale" Then
            cc.Range.Text = Result(0)
        End If
        If cc.Title = "nome" Then
            cc.Range.Text = Result(1)
        End If
    Next cc

    On Error Goto 0
End Sub


Sub LeggiDatiPaziente()
    Dim cf As String

    cf = InputBox("Inserire il codice fiscale", "Codice fiscale")

    LoadPatientData cf
End Sub

L'idea iniziale era di esporre i dati via JSON ma in VBA non mi sembrava così immediato senza dover ricorrere a delle librerie esterne ed ho quindi ritenuto di esporre i dati separati da un "banale" separatore ::

Lato server avevo a disposizione, già configurato e pronto all'uso, un Apache con PHP ed ho quindi predisposto un semplice script che assomiglia a quanto segue:

<?php
  header('Content-Type: text/plain; charset=UTF-8');

  $cf = $_GET['cf'];

  $conn = new PDO("pgsql:host=x.y.z.k;dbname=anagrafe", '...', '...');
  $stmt = $conn->prepare("select ... where codice_fiscale=:cf");
  $stmt->execute([ 'cf' => $cf ]);
  $patient = $stmt->fetch(PDO::FETCH_ASSOC);

  echo ...
?>

non sono necessari particolari controlli, l'utilizzo di una prepared statement è sufficiente e se per caso qualche cosa non va a buon fine pazienza, uscirà errore 500 oppure un risultato vuoto. Generalmente è necessario qualche cosa di più sofisticato ma in questo caso non serve niente di più di questo.

JQuery ed Ajax

Il passo successivo è stato di sostituire la parte Word direttamente da un HTML con JQuery che tramite AJAX va a leggere i dati dalla Web Api.

Di seguito le parti più interessanti del codice, ovvero come configurare la pagina in formato A4, con la sezione "header" invisibile in fase di stampa, e con l'impostazione delle interruzioni di pagina:

@page {
  size: A4;
  margin: 0;
}
@media print, screen {
        html, body {
                width: 210mm;
                height: 297mm;
                padding-left: 20px;
                padding-right: 40px;
        }
        h1 {
                font: 16px Arial, sans-serif;
                font-style: normal;
                text-align: center;
        }
        h2 {
                ...
        }
        ...
}
@media print {
        #header {
                display: none;
        }
        #consenso1 {
                page-break-after: always;
        }
}

nella pagina HTML sarà presente una semplica form dove caricare il codice fiscale ed altri dati fissi, e dove saranno presenti due pulsanti uno per la ricerca, uno per la stampa:

<form id='codice'>
Telefono: <input type='text' name='telefono' value=''><br/>
Codice fiscale: <input type='text' name='cf'>
<button type='submit' value='cerca'>Cerca</button><br/>
<button type='submit' value='stampa'>Stampa</button>
</form>

il codice JavaScript / JQuery è il seguente:

jQuery(document).ready(function(){
        $( "#codice button" ).click(function( event ) {
                if($(this).attr("value")=="cerca") {
                        # copia dei valori fissi
                        $('span#telefono1').text($("#codice :input[name='telefono']").val());
                        $('span#telefono2').text($("#codice :input[name='telefono']").val());

                        # sbianca i campi
                        $('span#cognome').text('');
                        $('span#nome').text('');
                        ...

                        # chiama la web api
                        $.ajax({
                                data: {
                                        cf: $("#codice :input[name='cf']").val()
                                },
                                type: "GET",
                                url: "anagrafe",
                                cache: false,
                                dataType: "text",
                                success: function(data) {
                                        var res = data.split("::");
                                        $('span#codice_fiscale').text('*' + res[0] + '*');
                                        $('span#cognome').text(res[1]);
                                        ...
                                }
                        });
                } else if($(this).attr("value")=="stampa") {
                        window.print();
                }
                event.preventDefault();
        });
});

Codice a Barre

I codici a barre stampati nella tessera sanitaria utilizzano il formato "Code 39". Per stampare il codice con lo stesso stile è necessario caricare ed il relativo font, disponibile anche tra i font di google:

@import url('https://fonts.googleapis.com/css2?family=Libre+Barcode+39+Text&display=swap');
span#codice_fiscale {
        font-family: 'Libre Barcode 39 Text', cursive;
        font-size: 36px;
}

Necessario ricordarsi che il codice, per essere letto correttamente dalla penna ottica, deve essere preceduto e seguito da asterisco.

Conclusioni

Dopo le prime settimane in cui regnava la confusione, ora la campagna vaccinale è partita a pieno ritmo, gli appuntamenti sono gestiti tramite un portale di buona qualità che viene messo a disposizione dalla regione (durante i periodi di picco aggiungono diversi server virtuali, grazie al cloud ma anche grazie ad una buona progettazione) ed i pazienti si congratulano per la buona organizzazione.

Il modulo consenso descritto in questo articolo e sviluppato e messo a punto nel giro di due pomeriggi è ancora attivo, e rimane comunque un valido supporto al servizio.

La PEC: progettata male e realizzata peggio

La PEC rappresenta il tentativo di trasporre la raccomandata con ricevuta di ritorno dal mondo analogico a quello digitale, con tutti gli identici problemi (inevitabili, ma conosciuti e accettati) più una miriade di problemi nuovi.

Ne ho viste di tutti i colori, caselle PEC piene di enti pubblici, importanti aziende, privati... (ma per quanto tempo sei tenuto a mantenere i messaggi?):

  • Ricevute arrivate, ma PEC sparite nel nulla.
  • Gente che pretende di inviare allegati da 200 MB (ogni provider ha regole diverse).
  • Gente che invia allegati in formati strani e creativi. Cosa succede se il destinatario non è in grado di leggerli?

Oltre al problema, noto, ovvero che non sempre si conosce l'associazione tra casella di posta e soggetto giuridico che ci sta dietro.

A livello di sicurezza poi non ci siamo. I server di posta tradizionali — Postfix, Exim, Dovecot — sono software open source, usati da milioni di persone nel mondo, aggiornati regolarmente, e comunque presentano costantemente numerosi bug. Figuriamoci un software proprietario, chiuso, gestito da pochi fornitori: chi lo sviluppa? Chi lo aggiorna? Quanti occhi lo guardano? Se i bug si trovano anche nei progetti open source più grandi e controllati, cosa ci si può aspettare da un software di nicchia che nessuno può vedere?

Poi certo agli utenti piace, sostanzialmente perché possono inviare infinite "raccomandate elettroniche" a costo quasi zero ed il destinatario ha l'obbligo di rispondere.

Purtroppo si tratta di uno strumento che cerca di risolvere un'esigenza reale, però è progettato male e realizzato peggio.